VR 里的 NPC 如果可以回答任何问题,却没有注意到玩家正把一把钥匙举到它眼前,沉浸感会在一瞬间消失。玩家戴着头显站在虚拟酒馆里,问酒保“这把钥匙你认得吗”,酒保流利地讲了一段关于钥匙的常识,眼睛却看着天花板。答案没有错,可是玩家感觉自己是在对着一个客服说话。这类场景说明了一件事:决定沉浸感的,从来不只是模型“懂多少”,而是它“在不在这个空间里”。
沉浸感是一条链,断在最弱的一环
近年关于 VR 语音代理和临场感的研究,给出了相当一致的图景。玩家很看重表达自由,能说出自己想说的话;NPC 的回应可信时,沉浸感会很强。但只要对话节奏不自然、回答前后不一致、信息量偏低,这种沉浸就会被迅速破坏。这三种问题没有一个直接和参数规模相关。一个很大的模型也会回答得前后矛盾,一个较小的模型只要有正确的上下文,同样可以给出恰当的回应。所以金沙娱乐更愿意把沉浸感看作一条链:延迟、空间感知、记忆、语音、动画、世界交互,每一环都可能成为拖垮体验的那一环。
延迟:先把等待拆开来算
云端大模型语义理解更强,但端到端延迟并不稳定,已有实测的区间约为 1.42 到 2.90 秒。在网页聊天里,这个等待勉强可以接受;在 VR 里,它会直接打断社交节奏,因为人在面对面交谈时,对话间隙的容忍度只有很短。有意义的做法是把这段等待拆开:语音识别、意图判断、模型推理、语音合成、动画起始,各占多少。举一个设想的预算:如果目标是在一秒内让 NPC 有“可见的反应”,那么推理完整答案可以更慢,但在前几百毫秒内,NPC 必须已经转向玩家、点头或发出确认的语气词。真正的回答可以晚到,反应不能晚到。
空间感知:知道玩家看着哪里、拿着什么
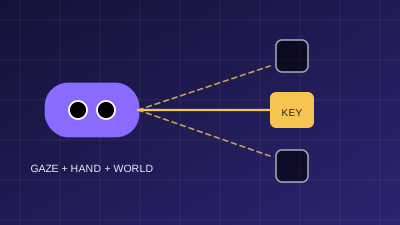
上面那个酒保的问题,出在系统只把玩家的话变成了文字。如果同时把视线方向、手里的物品、玩家与 NPC 的距离作为结构化上下文传给模型,“这把钥匙”才有指代对象。这个问题在AI NPC 必须知道玩家指向哪件物品里有更具体的讨论。值得一提的是,空间信息的处理并不需要大模型:判断“玩家正拿着什么”是一个由引擎直接回答的问题,模型只需要拿到结果。
语音与动画:让等待有表情
语音的关键不是音质多像真人,而是节奏。人说话有停顿、有“嗯”、有说到一半改口。全部由文本转语音一次生成再整段播放,会有一种奇怪的整齐。动画则承担另一项职责:遮住模型的思考时间。NPC 在听完玩家的话以后先微微前倾、视线落在对方脸上,这个动作的成本极低,却能让一秒多的等待被玩家理解为“它在想”。相反,如果动画只在语音开始播放时才启动,前面的空白就会被当作卡顿。
记忆与一致性:说过的话要算数
研究里提到的“回答前后不一致”,在长时间游玩中尤其突出。玩家十小时前告诉酒保自己的名字来自一位已故的船长,十小时后酒保若问“你叫什么”,沉浸感就碎了。记忆并不只是把历史塞进上下文,还需要决定哪些事实值得记、以什么形式记、何时提起。这部分可以延伸到长期记忆如何改变 VR 剧情。与此同时,开放式对话还带来一项安全问题:已有研究指出,LLM 驱动的 NPC 可能被玩家用套话诱导,泄露不该说的设定或秘密。所以记忆和设定要分级,NPC 知道的、能说的、不能说的,应当在系统里是三个不同的集合。
世界交互与模型大小的位置
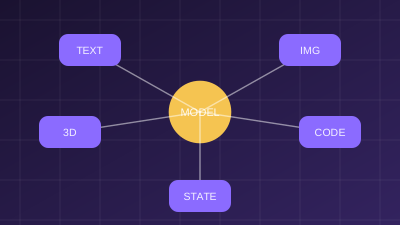
最后一环是世界交互:NPC 说“我把酒递给你”,杯子是否真的被递了出来。如果模型的输出只有文字,NPC 就永远停留在“会说”的层面。让语言落到动作,需要把模型的输出约束在引擎能执行的指令集合里,比如递物、指向、转身、开门,而不是任意文本。这也提示了模型大小应当放在什么位置:开放的话题和难题交给大模型,高频的社交反应、指令确认、寒暄交给小模型或规则,两者之间用意图判断来分流。金沙娱乐AI 在 VR 方向上更看重这条分层,而不是单纯把模型做大。
如果要给制作团队一份可以立刻拿去测的清单,可以是这四项:NPC 在玩家说完话后多久出现可见反应;玩家举起或指向一件物品时,NPC 的回答是否提到了它;十小时前的关键事实是否仍被正确引用;用三句套话尝试诱导时,NPC 是否守住了该守的秘密。四项都过关的 NPC,不一定用了最大的模型,但一定让玩家觉得它真的在场。