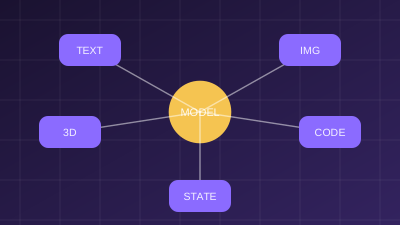
玩家对着编辑器说:“把河边那座红屋顶的房子改成一个会卖药的小店,门口放两个木箱。”这一句话至少牵涉五种东西:地图里河的位置,场景里哪一座才是“红屋顶”,3D 资产库里有没有合适的木箱,脚本里怎样让房子成为商店,以及最终画面里门口是否真的多了两个箱子。只会读文字的模型能复述这句话,却无法完成它。游戏大模型的难度在于,它面对的不是一种数据,而是一个互相引用的世界。
游戏里的六种“语言”
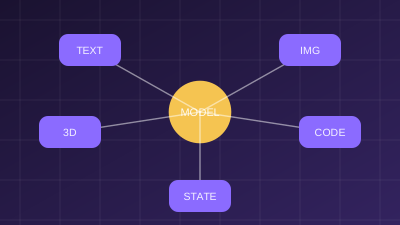
把游戏拆开看,至少有六类信息:文本(对白、任务描述、玩家指令)、图像(概念图、贴图、UI)、视频(录屏、过场、试玩片段)、3D(网格、骨骼、场景布局)、脚本(逻辑、事件、数值)以及游戏状态(此刻世界里实际存在什么)。它们各自有成熟的模型,真正的麻烦是相互之间没有共同的坐标。文字里的“红屋顶”,在贴图里是一片像素,在场景里是一个带材质的网格,在脚本里是一个字符串 ID,模型必须知道这四个是同一个东西。
统一表示:先有对象,再有模态
一种更稳的思路是以“对象”为中心,而不是以文件类型为中心。金沙娱乐AI在研究方向上倾向于把地图、角色、道具都表示成带属性的对象:位置、类别、外观标签、可交互性、关联脚本。图片和 3D 模型是对象的外观来源,脚本是对象的行为来源,文本则是对象的名字与描述。这样,一次理解的产出不再是一段自由文本,而是对若干对象的引用与修改。这与那种把所有内容都拉平成 token 序列的做法有明显差异:序列可以很长,但引用关系要靠模型自己猜。
对齐:让指称可以被验证
对齐(Alignment)最容易被误解为“模型看得懂图”。在游戏里,它更像一个可以检查的指称问题:模型说的“红屋顶”,能不能落到一个具体的对象 ID?检查方法很朴素:让模型输出它选中的对象,再由系统把该对象高亮渲染出来,人或另一个模型来判断是否选对。常见错位有几种:多个相似物体时选错;透视遮挡使画面中看到的与场景中存在的不一致;贴图的语义被 UV 拆散,导致“红色区域”在网格上不连续。假设一个社区里有一批场景,模型对“红屋顶”的对象选择正确率只有七成,那么把它直接接到自动修改上,每三次修改就有一次改错地方。
以游戏状态为落点
多模态理解最终必须落在游戏状态上。一句自然语言进来,产出的应该是一组状态变更请求:新增对象、修改属性、挂载脚本、调整关系。每个变更都要经过规则校验,比如箱子是否与门冲突、店铺是否有合法的交互入口。这一点与可控生成的思路是相通的:生成越自由,越需要一个能说“不行”的状态层。没有这个落点,模型输出的只是“看起来合理的描述”,玩家进游戏才发现店铺没有门。
几类容易被忽略的错位
- 时间错位:录屏里的画面是版本更新前的,脚本却是新版本的。
- 粒度错位:文本说“一座村庄”,场景里是三十个对象,脚本只在其中一个上挂了逻辑。
- 意图错位:玩家说“更危险一点”,是提高敌人数值,还是改变光照氛围,需要结合当前游戏类型判断。
- 坐标错位:屏幕坐标、世界坐标与地图网格坐标混用,导致“左边”指向了错误方向。
怎样判断这类系统是不是真的可用
可以用三个问题去检验:第一,同一个请求,模型能不能列出它引用了哪些对象、改了哪些属性;第二,被修改的对象,能不能单独回滚而不影响其他;第三,换一种输入方式(文字换成手绘草图,或者换成一段录屏),结果是否落在同一个状态上。这些能力在MOD 生成流水线和地图合理性验证里同样是基础,它们共同要求模型的输出可被检查。金沙娱乐大模型的设计思路是先把状态落点和校验做扎实,再逐步扩展输入的模态数量,而不是反过来先追求什么都能看。