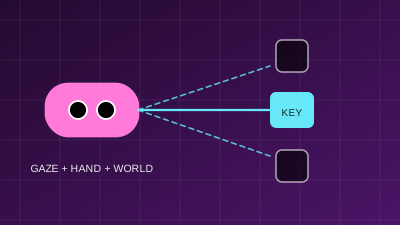
VR 里的 NPC 如果可以回答任何问题,却不知道玩家正把一把钥匙举到它眼前,沉浸感仍然会瞬间消失。玩家已经在虚拟世界里做出了一个明确的动作,而对方仍在礼貌地回答“你好,有什么可以帮你”,这个落差比任何机械感的语音都更破坏在场感。
三层能力缺一不可
大语言模型(LLM)让 NPC 第一次可以听懂玩家随口说出的话,这是真实的进步。研究里也反复出现类似的结论:玩家很重视表达自由,NPC 的回应可信时,沉浸感会很强。但同一批研究也提醒,对话节奏不自然、回答前后不一致、信息量低,都会明显破坏沉浸。
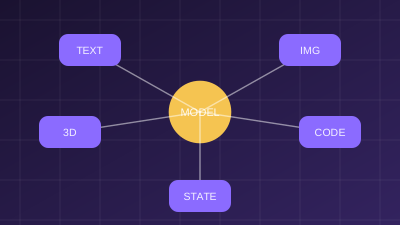
把这些放在一起,一个可信的 VR 中的 AI NPC 需要三层能力叠加。第一层是语言:语音识别(Speech)、意图理解和语言生成,其中区分“闲聊”与“下达指令”本身就是一道难题,可以看语音意图判断的拆解。第二层是空间:玩家看向哪里,手里拿着什么,站在离 NPC 多远的位置。第三层是游戏世界状态:这件物品现在是什么状态,任务进行到哪一步,NPC 记得玩家之前做过什么。语言层单独存在,得到的是一个会聊天的客服;三层叠加,才是一个“在这个世界里”的角色。
空间上下文:让“这个”和“那个”有所指
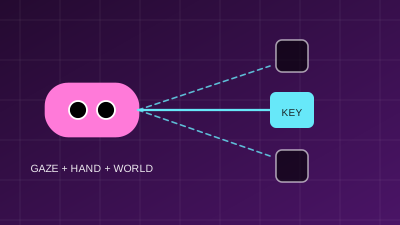
玩家在 VR 里最自然的说话方式,是带着指代词的:“这个多少钱”“你看这把钥匙”“把它放那边”。语言模型如果只收到转写文本,这些指代词是空的。要让它们有所指,就要把空间信息一并交给系统:视线(Gaze)指向的物体,手部追踪(Hand Tracking)识别到的手中物品和指向方向,玩家与 NPC 的相对位置和朝向。
在实现上,更稳妥的做法是把这些信息整理成结构化字段再交给模型,而不是让模型自己去推断。例如:“玩家最近两秒注视的物体是铁钥匙;右手正握持这个物体;与 NPC 距离约一步半。”模型拿到这些明确事实,就能把“这个”对应到具体物体。这个问题在空间指代那篇里有更细的展开。
假设玩家把一把生锈的钥匙举到 NPC 面前问:“这是开哪扇门的?”系统如果只有语言层,会给出泛泛的猜测;如果有空间层和世界状态层,就能确认玩家正拿着的是“地下室的钥匙”,NPC 才能回答“这把是仓库后门的,锁孔上还沾着油”。前者是聊天,后者是在场。
世界状态与记忆:让回答保持一致
AI-native 游戏相关的综述指出,运行时生成难以控制,尤其当输出必须和游戏状态、规则保持一致;持久记忆、世界状态追踪和长期后果管理仍然比较脆弱。放到 NPC 身上,就是两类常见错误:说出与当前物品状态矛盾的话(门明明已经打开,NPC 还在提醒玩家去开门),以及前后不一致(同一个角色,前一次说自己从没出过城,后一次却聊起了远方的经历)。
对应的设计思路,是把物品状态(Object State)和 NPC 记忆(NPC Memory)放在游戏系统里维护,由游戏规则作为权威来源,语言模型只读取并转述,不负责保存事实。玩家十小时前说过的话如何被压缩与召回,可以参考NPC 长期记忆的讨论。记忆的要点是分层:短期场景事实、任务相关事实、长期关系,各自有不同的保留和遗忘策略。
延迟:分开处理“反应”和“回答”
云端语言模型的语义理解能力更强,但端到端延迟不稳定。相关研究给出的实测区间约在 1.42 到 2.90 秒之间,在 VR 里这个长度足以打断社交节奏,因为人与人的对话间隔比这短得多。
一个可行的思路是把 NPC 的反应分成快慢两条路。快的一条由本地规则驱动:视线转向玩家、点头、目光落在玩家手中的物体上,立刻给出“我在听、我看到了”的信号。慢的一条由语言模型生成完整回答,可以先用一句短的过渡语(“嗯,让我看看这把钥匙”)覆盖等待。玩家感受到的是“对方一直在注意我”,而不是“对方停机了几秒”。
开放式对话的代价与设计清单
放开表达也有代价。开放式交互会提高玩家的认知负荷,玩家面对一个“什么都能说”的角色时,往往不知道该说什么。另有研究指出,LLM 驱动的 NPC 存在被“套话”泄露设定或秘密的风险,所以世界设定和任务答案不应该整体放进模型可随意复述的上下文里。
金沙娱乐AI 在 AI VR 游戏方向上,更倾向于用一份清单来检验一个 AI NPC 设计,这些都是设计思路,不是已经发布的功能:
- 玩家说“这个”时,系统能否拿到视线和手持物,并把它们对应到具体物品。
- 物品状态和任务进度是否由游戏系统作为权威来源,模型只读取。
- NPC 是否有独立于语言生成的快速反应通道,用于应对等待。
- 秘密与设定是否做了访问控制,而不是完全依赖提示词自觉。
- 玩家不知道说什么时,NPC 是否会给出引导,降低开放对话的认知负担。
语言理解让 NPC 能听懂玩家,空间理解让它看见玩家,游戏世界状态让它说得对。三者缺一,NPC 就只是一个嵌进虚拟世界的聊天窗口。