生成一张漂亮的游戏画面已经不再稀奇,实时神经渲染真正难的是镜头转过去再转回来时,那堵墙仍然应该是同一堵墙。单帧里砖缝的纹理再精致,只要下一帧它换了一种排列,玩家看到的就不是“更好的画质”,而是一堵会呼吸的墙。
单帧好看,为什么不等于连续稳定
神经渲染(Neural Rendering)和生成式渲染(Generative Rendering)有一个共同的特点:模型在每一帧都要“做决定”。这块金属该有多亮,这块布料的纹理应该往哪个方向走,这团阴影的边缘落在哪里。传统渲染管线里,这些由光照方程和材质参数确定,同样的输入总会得到同样的输出。模型则不同,输入里一点很小的扰动,比如相机移动了半个像素,输出就可能落在另一个同样合理的答案上。
如果只评估单帧,两个答案都很好看;把它们连成视频,就是闪烁(Flicker)。这也是为什么单帧的截图对比常常会误导人:截图评估的是“合理”,而玩家体验的是“一致”。60 帧每秒的画面里,每一秒有 60 次机会出现小的不一致,每次都不大,但眼睛对时间变化极其敏感。
闪烁通常出现在哪里
假设有一个夜晚的城市场景:湿润的路面、霓虹反射、远处的铁丝网。三类内容最容易出问题。
第一类是光照。光源方向稍有变化,模型对阴影边缘的判断可能来回摆动,表现为阴影边缘“爬行”。第二类是材质。金属、皮革、湿润表面对高光非常敏感,模型可能在相邻帧里把同一块表面识别成不同的材质,看起来像是材料在变化。第三类是运动。物体运动时,模型要把上一帧的信息对齐到当前位置,一旦对齐错了,就会出现拖尾、重影,或者细节从旧位置“滑”到新位置。
这些问题的共同点是:它们的根源都是“上一帧的信息没有被正确地继承到这一帧”。这与帧生成里的运动伪影同源,只是在神经渲染里,被改写的不再只是位置,还包括光和材质。
用引擎信息约束生成,而不是事后平滑
一个直觉上的办法是:既然闪烁,就对输出做时间平滑。但平滑会带来新问题,运动的物体会被抹掉,正确的变化(比如爆炸的闪光、关门后的光线变化)也会被一起压下去。更可靠的思路是在输入端下手,让模型没有机会“自由发挥”。
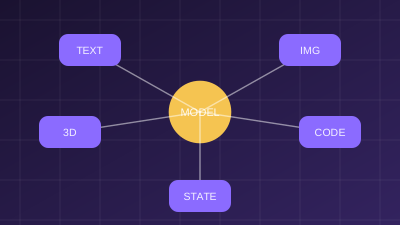
NVIDIA DLSS 5 的定位就是一个很好的例子。它被称为 3D 引导的神经渲染(3D-Guided Neural Rendering):游戏引擎仍然负责渲染几何、相机、动画和基本场景结构,神经模型读取已渲染的颜色帧和运动信息,再改写光照与材质的外观。它不是纯粹的图像重建,也不是完全自由的图像生成。DLSS 5 于 2026 年 9 月 3 日随《NBA 2K27》发布,可用于 GeForce RTX 50 系列和 GeForce NOW。
这个路线的价值,不在于它选择了某一种模型,而在于它明确了分工:什么东西在哪里、怎么运动,由引擎给出确定的答案;模型只负责“这些东西应该被怎样照亮、看起来是什么质感”。引擎把物体身份和运动固定住,模型能发生偏差的空间就小得多。传统引擎在这类管线里究竟还负责什么,可以参考神经渲染时代的引擎分工。
把“一致”变成可以测的指标
要让团队讨论稳定性,必须先能测量它。我们更倾向于把“一致”拆成三类检查,而不是给出一个模糊的总分。
| 检查类别 | 要问的问题 | 典型测试场景 |
|---|---|---|
| 光照一致 | 同一光源下,阴影和高光方向是否稳定 | 缓慢移动光源、日夜过渡 |
| 材质一致 | 同一表面在不同帧中是否保持同一种质感 | 相机绕物体旋转、近景与远景切换 |
| 运动一致 | 运动物体的细节是否跟着物体走 | 快速转镜、载具高速通过 |
更苛刻的一项是“回访测试”:镜头转开再转回来,同一处场景的外观是否回到原样。这一项对世界模型和纯生成式方案特别严格,因为它们没有引擎保存的确定几何,要靠模型自身的记忆来保证。这正是把生成限制在引擎信息之内的另一个理由。
发布前该怎么判断可用
金沙娱乐AI 在评估神经渲染和 AI 画质方案时,更倾向于把稳定性放在画面质量之前,因为一个偶尔惊艳但经常闪烁的方案,玩家玩十分钟就会关掉。具体到一个上线前的检查,可以按下面的顺序:
第一,用固定相机路径反复播放同一段场景,对连续帧做差异分析,找出差异集中出现的区域。第二,在快速转镜、往返和光源移动三类场景里逐一测试,并记录哪些内容最先出错。第三,检查引擎是否向模型提供了足够的运动信息,缺失运动向量的物体(粒子、透明物体、界面)要有单独的处理策略。第四,允许玩家在设置里切换生成强度,让稳定性成为可以调节的选项,而不是全有或全无。
也就是说,神经渲染的成败不在于它能把单帧画得多漂亮,而在于连续 60 或 120 帧里,同一件东西是否被认成同一件东西。这个判断标准,比任何对比截图都更接近玩家的真实感受,也和真实渲染与生成画面的边界这个话题直接相关。