游戏发布 1.8 补丁的第二天,MOD 社区最热的帖子通常只有一句话:“所有 MOD 都崩了。”翻开日志,原因往往小得让人泄气:一个函数从 GetItem 改名为 FindItem,一个 “speed” 字段被拆成 “walkSpeed” 和 “runSpeed”,一张图集重新排布以后,所有头像都往右偏了一格。修复这些问题几乎不需要创造力,需要的是耐心和对照表,这恰好是 AI 的强项。
旧 MOD 是怎么失效的
失效大致有三种形态。第一种是 API 变更(API Change):脚本调用的函数被改名、删除、参数顺序变化或返回值语义变化,表现为报错或者静默地行为不对。第二种是资源变更(Asset Change):贴图尺寸、图集布局、模型骨骼命名、数据表结构变化,MOD 里的资源不再对得上。第三种是脚本错误(Script Error):MOD 本身没变,但它依赖了旧版本里的某种“偶然行为”,比如某个事件恰好在某一帧触发,新版本调整了触发时机,脚本就出错。三种形态的修法不同,所以第一步就是分类,而不是把报错扔给模型。
为什么这是 AI 最划算的场景之一
写一个新 MOD 是开放问题,没有标准答案;修复旧 MOD 则是封闭得多的问题。它有四个有利条件:其一,有前后两个版本,变更的信息本身就是输入;其二,变更模式高度重复,同一次补丁引起的失效在几十个 MOD 中长得几乎一样,一次学会可以处处复用;其三,结果可验证,旧 MOD 在旧版本上的行为是现成的“标准答案”,修复以后行为应该一致;其四,需求真实存在,很多 MOD 作者是业余的,游戏更新之后并不总有时间回来维护。金沙娱乐更倾向于把这个场景视为 AI MOD 工具的基础能力,而不是附加功能。
流程:diff、定位、改写、回归测试
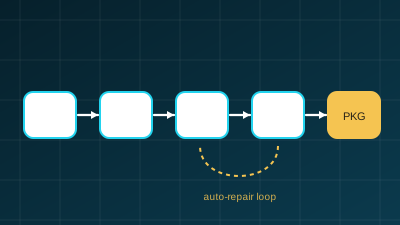
第一步是 diff:把新旧两个版本的公开接口、数据模式、资源清单做结构化对比,得到一份“变更清单”,比如函数改名、字段拆分、资源移动。不要让模型直接读几十万行代码去找不同,工具可以精确得多。第二步是定位:把变更清单和 MOD 的调用点做交集,例如 MOD 里有 7 处调用了改名的函数,其中 2 处在只有特定存档才会执行的分支里。这一步得到的是一份“受影响点”列表,每一处带着上下文。
第三步是改写:针对每个受影响点,结合变更清单里的对应关系生成最小改动。改名就换名,字段拆分则要判断原来那个值应该映射到哪一个新字段,或者两个都写入。这里的关键是保持改动小而可读,方便作者审阅。第四步是回归测试:先在旧版本上录制 MOD 的行为基线,比如加载后角色属性、触发事件的顺序,再在新版本上重放,对比差异。对比通过,才算修好;对比失败,把差异连同修改一起送回第三步。这条链路和MOD 生成流水线的最后几步是同一套设施,区别只是输入从自然语言变成了变更清单。
自动迁移:数据与存档也要一起走
脚本修好还不够。角色数据要迁移到新的模式,比如把旧的 speed 值写入两个新字段;已有存档里的 MOD 数据也要迁移,否则玩家读档时会发现自己的队友消失了。自动迁移(Automatic Migration)的原则是可逆:迁移前先备份,生成迁移脚本而不是直接改存档,迁移失败能够回退。同时,修复后的 MOD 要更新清单里声明的兼容版本,让冲突检测重新跑一遍,因为补丁可能也改变了别的 MOD 的接触面。
哪些不该自动修
结构性变化可以自动化,语义性变化不行。假设官方补丁把所有近战武器的伤害整体下调了 20%,一个把某把剑“调成略强于同类”的 MOD,脚本没有任何报错,却已经不再是作者当初想要的平衡。这类变化在 diff 里表现为数值变化,但它是否需要跟着调整,只有作者能回答。合理的做法是分级:可以确定映射的自动修;有多种可能的映射时给出候选并标注置信度;涉及数值、剧情、平衡的,只提示“这里官方改了,你可能需要复查”。
衡量一个修复系统的四个指标
看它能修多少,不如看它修得是否让人放心。可以用四个指标:自动修复通过回归测试的比例;修复改动的行数中位数,越小越好;提示给人的比例,太低说明它在“替人做决定”,太高说明它没什么用;补丁发布后到 MOD 可用之间的时间。这几个数字,比“支持多少种 API 变化”更能说明系统在真实的更新日里是否靠得住。